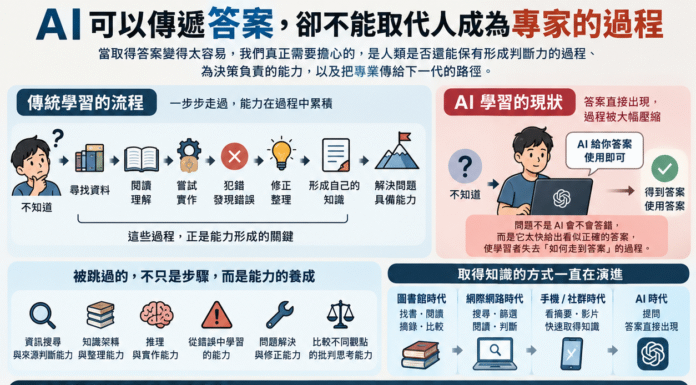
AI真正影響的是我們的判斷力、責任與傳承能力,AI不會淘汰人,但會淘汰不會使用AI的人,當你無腦使用AI時,你所消磨的是你的判斷力、責任與傳承能力。
1. 判斷力:沒有走過過程,就越難判斷答案
傳統學習裡,判斷力不是老師直接「教」出來的,而是在一次次比較、犯錯、修正中形成。
查資料 → 發現資料互相矛盾 → 判斷來源 → 自己嘗試 → 發現錯誤 → 修正
久了以後,人會產生一種很重要的能力:
「這個答案看起來怪怪的。」
這種直覺其實來自大量的基礎知識與失敗經驗。
AI 卻可能讓流程變成:
提出問題 → AI 給答案 → 答案看起來合理 → 接受
因此真正危險的不是「AI 偶爾答錯」,而是:
當一個人沒有足夠的基礎知識時,他甚至不知道 AI 什麼時候答錯了。
2. 責任:答案不是我做的,那錯了算誰的?
傳統上,一個專業人士必須對自己的判斷負責。
工程師簽核設計、醫師做醫療判斷、會計師確認財報、主管做決策、程式設計師上線程式,背後都有一個基本原則:
「因為我理解,所以我決定;因為我決定,所以我負責。」
但...

當我們使用AI,會覺得很方便,但方便的背後,是因為我們已經經過許多試錯過程,所以我們可以
判斷結果的真實性
判斷哪些可以直接用
哪些可以節錄出來
但如果你沒有經過這樣的過程,你就只是把AI結果直接拿來用,而不是使用AI來完成工作,以下文章是AI幫我寫的,但思路是我給它的,並且經過反覆修正,所以我可以正確表達我想表達的,以下文章是AI透過我的思路幫我生成的,大家可以參考
AI 正以前所未有的速度進入我們的工作與學習。
今天的孩子可以利用 AI 寫文章、解數學題、學英文;剛進入職場的工程師,可以讓 AI 幫忙寫程式、找 Bug、產生 SQL,甚至完成過去需要相當經驗才能處理的工作。
這毫無疑問是一場巨大的生產力革命。
但是在享受 AI 帶來便利的同時,我一直在思考另一個問題:
如果 AI 幫助下一個世代跳過了「從初階走向進階」的學習過程,我們會不會也因此切斷了專業能力的世代傳承?
而這件事情,其實不是到了 AI 時代才開始發生。
回頭看看電腦、網際網路與智慧型手機的發展,我們已經可以看到類似的世代差異。
每一個世代,都曾經認為上一代的技能「沒有必要」
我們這一代其實也曾經做過同樣的事情。
當計算機與電腦普及之後,我們可能開始覺得:
「為什麼還要花那麼多時間學習手工計算?」
電腦明明幾秒鐘就可以算出答案。
當網際網路與搜尋引擎普及之後,我們又開始覺得:
「為什麼還要去圖書館一本一本找資料?」
在網路上輸入關鍵字,幾秒鐘就能找到數百萬筆資訊。
到了智慧型手機世代,又產生另一個有趣的現象。
對從電腦時代成長的人來說,「會使用電腦」可能包括檔案與目錄、安裝軟體、設定系統、管理硬碟,甚至知道一些基本的網路概念。
但是對從小使用手機和平板的孩子而言,很多事情已經被隱藏起來。
他不需要知道程式安裝在哪裡,不需要知道什麼是目錄結構,也不一定需要理解檔案究竟存放在哪裡。
點一下 App,一切就可以運作。
於是我們可能會看到一個很有意思的世代循環:
會使用電腦的一代,覺得上一代某些基礎計算沒有必要。
會使用網際網路的一代,覺得去圖書館查資料沒有必要。
會使用智慧型手機的一代,又覺得很多電腦基礎知識沒有必要。
現在到了 AI 時代:
會使用 AI 的下一代,會不會開始覺得「自己尋找答案」也沒有必要?
工具越進步,底層的複雜性就越被隱藏
這其實是科技進步很自然的方向。
好的科技,本來就應該把複雜的事情變簡單。
開車的人不需要了解內燃機才能開車。
使用手機的人不需要了解 TCP/IP 才能上網。
使用搜尋引擎的人,也不需要理解資料庫與搜尋演算法才能找到資料。
科技就是不斷替人類建立更高一層的抽象。
問題是:
當我們站得越來越高,我們是否還知道腳底下有什麼?
圖書館時代的人,尋找資料可能需要知道:
我要找什麼?
應該去哪一類書籍尋找?
這本書是誰寫的?
作者是否可信?
這是第一手資料還是第二手資料?
不同資料之間是否互相矛盾?
搜尋引擎把「尋找資料」這件事情大幅簡化了。
但至少使用搜尋引擎時,我們仍然看得到不同來源。
我們可能看到政府網站、新聞媒體、論文、論壇、部落格,再自行決定相信哪一個。
AI 又往前走了一步。
我們甚至不一定需要「找資料」。
我們只要問:
「告訴我答案。」
AI 就會整理出一個完整、流暢,而且看起來非常合理的回答。
於是原本:
問題 →...

ISO/IEC 27001:2022就是具備風險思維的PDCA流程,並建立符合自己適用範圍以及適用性聲明的ISMS資訊安全管理系統。

CentOS防火牆增加Port都是透過firewalld這個服務的指令firewall-cmd來進行,可以用來增加防火牆的Port或者查詢目前有哪些Port已經開放
增加開放Port
如果我要開放1234 Port,可以用已下指令
firewall-cmd --zone=public --add-port=1234/tcp --permanent
請加上--permanent,不然firewalld重新啟動就失效了
下完指令之後要重新啟動firewalld,指令如下
firewall-cmd --reload
確認已開放的Port
透過以下指令可以查出所有開放的Port
firewall-cmd --zone=public --list-all
Zone
你會看到以上指令都會指定一個Zone,這是用來指令指令的適用範圍,如果不指定就是所有的Zone都生效,預設的Zone有以下幾種
drop : 最嚴格
block
Public: 不信任任何連線,但可以將允許項目一個一個加入
external
dmz
work
home
internal
trusted: 接受所有連線
Firewall-cmd完整參數
主要指令:firewall-cmd
--permanent:指令下了之後都是暫時狀態,重開機之後就會消失,如要永久生效,記得加上 參數
--zone:指定此設定要套用到哪一個Zone
--add-rich-rule:加上防火牆過濾條件
--add-port=80/tcp:這個範例是把TCP 80 Port加入允許清單,要指定tcp/udp的話要分成兩個指令
--remove-port=80:將80 Port由允許清單移除
ChatGPT是一種GPT的應用,GPT是「生成型預訓練變換模型(Generative Pre-trained Transformer)」的縮寫,是一種語言模型,也就是說ChatGPT是預先用大量人力生成的AI引擎,並且應用在Chat領域,ChatGPT對應晶片需求約要3 萬多片輝達圖形處理器,預估初期投入成本約為8 億美元,每天電費更高達5 萬美元左右,燒錢又耗電,而且有時候我自己覺得ChatGPT經常會胡說八道,產出的內容常會與現實不符。
ChatGPT的最大優點是,他聽得懂我們要的東西,並且精確回答我們需要的答案,但有時候當我們給了一些錯誤的資訊,他所回應的答案就會是有偏差的內容,因為他假設我們給的資訊都是對的,當然,如果有明顯的錯誤,他是會抓出來的。
當我們給他幾個關鍵字,他就會生成一篇文章,但這篇文章可能跟我要表達的有所差距,例如我這兩天在一場主日訊息中做了幾個關鍵字的紀錄,這時候我餵給ChatGPT,內容如下
疫情後
老闆和老師都不能倚靠過去的經驗
要面對物價上漲 公司上漲
老師也要線上教學 變成網紅
ChatGPT的挑戰
結果ChatGPT的回應是
疫情後,許多人都面臨著各種挑戰和改變,包括老闆、老師和ChatGPT等人工智慧系統。以下是幾個與您提到的情境相關的挑戰:
面對物價上漲和公司調漲:疫情對全球經濟產生了影響,物價上漲成為一個普遍的問題。老闆和企業可能需要面對原材料和運輸成本的增加,因此調整產品價格。這對企業經營和客戶滿意度提出了挑戰,需要尋找平衡點以維持可持續的營運。
老師轉向線上教學和成為網紅:疫情迫使許多學校轉向線上教學,這對老師而言是一個巨大的轉變。他們需要學習使用數位教學工具和平台,並將教學內容適應線上環境。同時,一些老師可能發現自己成為網紅,因為他們的教學內容在線上獲得了廣泛的關注和迴響。這可能需要他們學習個人品牌建立和內容創作的技能,同時保持對教學質量的關注。
ChatGPT的挑戰:ChatGPT作為一個人工智慧語言模型,也面臨著挑戰。儘管它具有強大的自然語言處理能力,但仍然存在理解上下文、回答問題的準確性和保持對倫理和隱私的遵從等問題。ChatGPT的進一步發展需要不斷的訓練和改進,以提供更好的回應和服務。
在面對這些挑戰時,關鍵是持續學習和適應新的環境。這包括掌握新技能、與其他人合作、尋找解決問題的創新方式等。同時,我們也應該意識到挑戰帶來的機會,並以積極的態度應對,以促進個人和組織的成長。
我原本想要他幫我做個摘要,但變成了一篇文章,有些我沒有提到的,他主動提到了,基本是都是正確的,只是部分不是我要的方向,這時候我重新問一下,結果就不太一樣了
疫情後,許多行業和個人都面臨了巨大的挑戰和變革,這也包括老闆、老師以及AI助手如ChatGPT。以下是一些ChatGPT可能面臨的挑戰:
適應新的需求:疫情後,許多業務和學校轉向線上模式。對於ChatGPT來說,這可能需要擴展其功能以支援更多線上教學、商業和其他應用需求。它需要能夠提供相關和有用的資訊,回答網絡使用者的問題並適應快速變化的情況。
資訊準確性和可靠性:ChatGPT應該提供準確和可靠的資訊,特別是在疫情期間,人們更加依賴線上資源。為了確保資訊的準確性,ChatGPT可能需要依賴來自可信賴來源的數據和訊息,並且能夠識別和排除不正確或具有誤導性的內容。
應對使用者情感和需求:疫情期間,人們可能處於壓力和焦慮之中,他們可能需要情感支持和指導。ChatGPT需要更加敏感地理解使用者的情感和需求,並提供適當的回應和支持。
隱私和倫理問題:在線上交互中,隱私和倫理問題變得更加重要。ChatGPT需要確保使用者的個人資訊和隱私得到適當的保護,同時遵守相關的法律和倫理標準。
這些是一些ChatGPT可能面臨的挑戰,隨著時間的推移和技術的發展,我們可以期待ChatGPT和其他AI助手能夠更好地滿足不斷變化的需求。同時,我們也應該持續關注和解決AI技術所引發的倫理和社會問題。
這一次他著重於ChatGPT這個議題,但這完全不是我要的,所以他的回覆看似豐富,但還是需要一些自我判斷,也許經過大家的訓練,他會有更加精確的結果,或者說他的精確度會著重於需要付費GPT-4服務,目前ChatGPT的免費服務是GPT-3的演算法。